
Desde hace unos meses, sigo de cerca la evolución de los modelos de IA capaces de pilotar agentes autónomos, y francamente, el panorama cambia a una velocidad impresionante. En septiembre de 2026, el ranking Arena nos ofrece una fotografía fascinante de esta feroz competencia entre los gigantes de la IA. Claude Fable 5.1 de Anthropic ocupa la primera posición, pero OpenAI regresa con fuerza con GPT-6 Astra, cuestionando la dominación que Anthropic había mantenido durante meses. Lo que me interesa particularmente es que esta batalla no se juega en los benchmarks tradicionales, sino en la capacidad real de los modelos para ejecutar tareas complejas en un entorno sandbox. Con casi 1,7 millones de sesiones de usuarios analizadas, este ranking representa una verdadera mina de oro para entender qué modelos realmente rinden cuando se trata de automatización agentica. En este artículo, propongo desglosar este ranking, explorar la metodología revolucionaria de Arena y mostrar cómo se posicionan estos modelos entre sí.
Claude Fable 5.1 : La Nueva Referencia de los Agentes IA
Claude Fable 5.1 se ha impuesto como el campeón indiscutido del ranking agentico de Arena en septiembre de 2026. Lanzado el 1 de septiembre, este modelo ocupó inmediatamente el primer lugar en su versión Max, superando a todos sus competidores. Lo que hace que esta victoria sea particularmente notable es que se basa en datos reales de uso en lugar de pruebas sintéticas. Debo admitir que me impresionó la coherencia del rendimiento de Claude Fable 5.1 a través de diferentes tipos de tareas. El modelo obtiene, de hecho, la tasa más alta de tareas validadas por los usuarios, lo que significa que los resultados que produce realmente corresponden a lo que la gente espera.
Anthropic ha claramente invertido masivamente en la optimización de sus modelos para las tareas agenticas 🤖. La estrategia de la empresa parece ser crear modelos especializados en lugar de soluciones generalistas. Claude Fable 5.1 representa este enfoque, con una arquitectura pensada específicamente para delegar flujos de trabajo completos a un agente autónomo. Las dos versiones de Claude Opus 5 completan el podio, ocupando el tercer y cuarto lugar, lo que muestra que Anthropic no depende de un solo modelo para dominar el mercado de agentes.
Lo que me fascina es la estabilidad de Anthropic en este ranking. La empresa ocupa seis de los diez primeros lugares, lo que demuestra un dominio profundo de los desafíos relacionados con la agentica. Esto contrasta fuertemente con la situación de agosto, donde Anthropic ocupaba los tres primeros lugares sin competencia. El ascenso de OpenAI ha obligado a Anthropic a mantenerse alerta, pero Claude Fable 5.1 demuestra que la empresa tiene los recursos y la experiencia para mantener su ventaja.
GPT-6 Astra : El Regreso Espectacular de OpenAI
GPT-6 Astra ha hecho su entrada triunfal en el ranking agentico, colocándose directamente en la segunda posición. Lanzado dos días después de Claude Fable 5.1, este modelo representa un cambio importante para OpenAI en la carrera por los agentes IA. Lo que me ha impresionado particularmente es que GPT-6 Astra es el primer modelo de OpenAI clasificado en el nivel de riesgo cibernético máximo, lo que indica un aumento significativo en sus capacidades. El mes anterior, el mejor modelo de OpenAI solo ocupaba el cuarto lugar, por lo que este ascenso espectacular merece ser destacado.
OpenAI ha trabajado arduamente para recuperar el terreno perdido en el ámbito de la agentica autónoma 🚀. GPT-6 Astra obtiene, de hecho, la mayor proporción de comentarios positivos de los usuarios, lo que sugiere que la gente realmente aprecia la forma en que este modelo interactúa con ellos. Sin embargo, hay un punto débil: GPT-6 Astra es el único del top 10 que muestra un puntaje negativo en la steerability, es decir, su capacidad para integrar correcciones cuando un usuario lo corrige. Este es un detalle importante que podría explicar por qué no ha ocupado el primer lugar a pesar de su excelente rendimiento general.
Creo que este rendimiento de OpenAI señala un cambio en la dinámica del mercado. Durante mucho tiempo, Anthropic parecía tener una ventaja indiscutible en los agentes IA, pero GPT-6 Astra muestra que OpenAI ha comprendido los desafíos y está invirtiendo masivamente en esta dirección. La competencia entre los dos gigantes apenas comienza, y eso es excelente para los usuarios que se beneficiarán de innovaciones más rápidas.
La Metodología Arena : Cómo Evaluar los Agentes IA
Lo que hace que el ranking de Arena sea particularmente creíble es su metodología revolucionaria llamada causal tracing. A diferencia de los benchmarks tradicionales que utilizan duelos anónimos y puntajes Elo, Arena observa las sesiones reales llevadas a cabo en Agent Mode, su entorno sandbox abierto en junio de 2026. Debo admitir que este enfoque me parece mucho más relevante que las pruebas sintéticas, ya que mide lo que realmente importa: el rendimiento en condiciones reales de uso.
La plataforma Arena agrega cinco señales clave para crear un puntaje único 📊. La primera es la validación o el rechazo del resultado por parte del usuario, lo que mide simplemente si el modelo ha hecho lo que se le pidió. La segunda señal captura los elogios y las críticas formuladas en lenguaje natural, ofreciendo una perspectiva cualitativa sobre la satisfacción. La tercera evalúa la capacidad del agente para integrar una corrección cuando es corregido, lo cual es crucial para los flujos de trabajo iterativos. La cuarta mide el número de pasos necesarios para recuperarse de un pedido fallido, y la quinta examina la propensión del modelo a invocar herramientas que no posee.
Lo que me impresiona en este enfoque metodológico es que ningún modelo domina todas las señales. Claude Fable 5.1 sobresale en la validación de tareas, GPT-6 Astra en los comentarios positivos, y las versiones de Claude Opus 5 en la integración de correcciones. Esto significa que cada modelo tiene sus fortalezas y debilidades, y que la elección del mejor modelo realmente depende de su caso de uso específico. Es una matiz importante que los rankings simples no capturan.
El Top 10 de Modelos para Pilotar Agentes en Septiembre de 2026
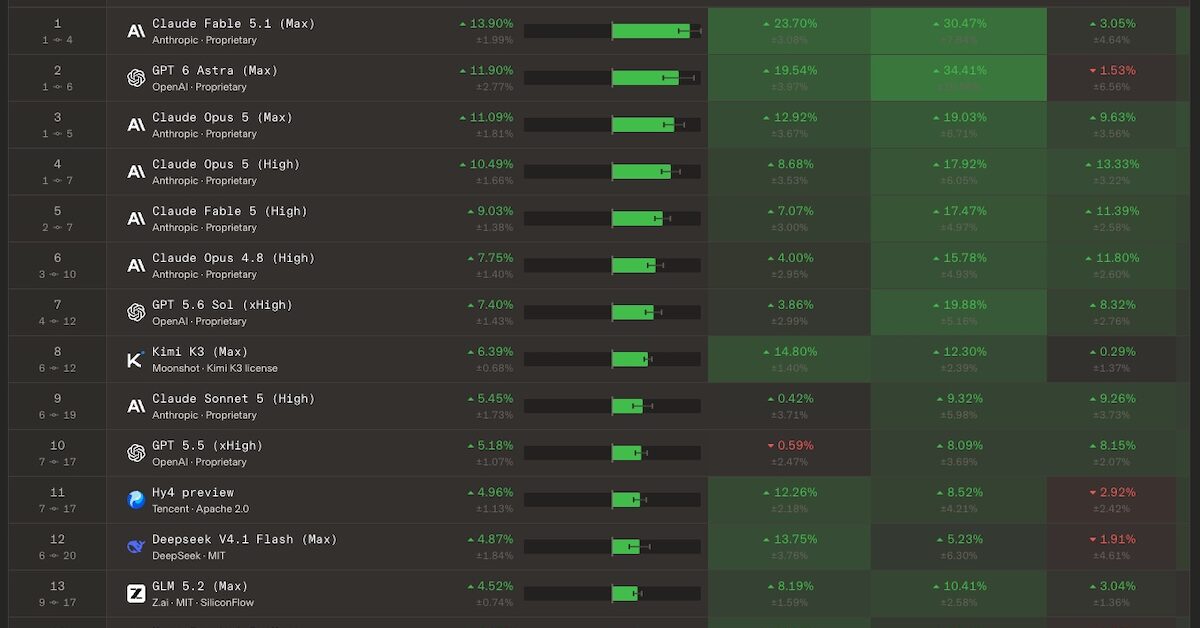
El ranking completo de los diez mejores modelos para agentes IA en septiembre de 2026 revela una jerarquía clara, pero también sorpresas interesantes. En primera posición, tenemos a Claude Fable 5.1 (Max), seguido de GPT-6 Astra (Max), Claude Opus 5 (Max), Claude Opus 5 (High), Claude Fable 5 (High), Claude Opus 4.8 (High), GPT-5.6 Sol (xHigh), Kimi K3 (Max), Claude Sonnet 5 (High), y GPT 5.5 (xHigh). Lo que me sorprende es la abrumadora dominación de Anthropic, que ocupa seis de los diez primeros lugares, frente a tres para OpenAI.
Kimi K3, el modelo open weight de Moonshot AI, retrocede del quinto al octavo lugar, mientras que GPT-5.6 Sol, que ocupaba el pie del podio en agosto, ahora es séptimo 📈. Esta volatilidad en el ranking muestra que el mercado de agentes IA es extremadamente dinámico. Detrás del top 10, el pelotón se estrecha considerablemente. Hy4 preview de Tencent aparece en la 11ª posición, seguido de DeepSeek V4.1 Flash, GLM 5.2 de Z.ai, y Muse Spark 1.3 de Meta. En agosto, había que bajar hasta la 13ª posición para encontrar otro actor que no fuera Anthropic, OpenAI o Moonshot AI, y a la 22ª para ver a Meta. Esto muestra que la concentración del mercado se ha reducido ligeramente, con otros actores que comienzan a emerger.
Google se mantiene a distancia con Gemini 3.6 Flash en la 34ª posición, mientras que Mistral, el único actor europeo en la tabla, se clasifica en la 41ª posición. Debo admitir que estoy un poco sorprendido por la debilidad relativa de Google y Mistral en este ranking. Ambas empresas tienen excelentes modelos, pero parecen no haber optimizado sus soluciones específicamente para las tareas agenticas. Es una oportunidad para ellos de recuperar el terreno perdido invirtiendo más en esta dirección.
Anthropic Domina, Pero la Competencia se Intensifica
La dominación de Anthropic en el ranking agentico es innegable, pero oculta una realidad más matizada. Sí, Anthropic ocupa seis de los diez primeros lugares, pero el ascenso de OpenAI con GPT-6 Astra muestra que la competencia se intensifica. Creo que estamos presenciando un momento crucial donde el mercado de agentes IA comienza a estructurarse alrededor de algunos actores principales. Anthropic ha claramente invertido masivamente en esta dirección, y eso está dando sus frutos, pero OpenAI no planea quedarse atrás.
Lo que me interesa particularmente es la estrategia de Anthropic de crear varios modelos especializados en lugar de un solo modelo generalista. Claude Fable 5.1, Claude Opus 5, Claude Fable 5, y Claude Sonnet 5 ofrecen todos perfiles de rendimiento diferentes 🎯. Este enfoque permite a los usuarios elegir el modelo que mejor se adapte a sus necesidades específicas, ya sea en términos de rendimiento máximo o eficiencia de costos. OpenAI parece seguir una estrategia similar con sus diferentes versiones de GPT, pero Anthropic claramente tiene una ventaja en la ejecución.
La presencia de otros actores como Moonshot AI, Tencent, DeepSeek, y Meta en el ranking muestra que el mercado de agentes IA no es un duopolio. Sin embargo, la concentración sigue siendo muy alta, con Anthropic y OpenAI controlando ampliamente los mejores rendimientos. Creo que probablemente veremos una consolidación del mercado en los próximos meses, con algunos actores que lograrán hacerse un lugar, mientras que otros desaparecerán o serán adquiridos. La d dinámica competitiva del sector crea oportunidades para los innovadores.
Las Implicaciones para las Empresas y los Desarrolladores
Para las empresas y los desarrolladores que buscan construir soluciones basadas en agentes IA, este ranking ofrece indicaciones valiosas sobre los modelos a utilizar. Si necesita el mejor rendimiento posible y el costo no es una preocupación importante, Claude Fable 5.1 parece ser la opción obvia. Sin embargo, si busca un buen equilibrio entre rendimiento y costo, o si prefiere trabajar con OpenAI, GPT-6 Astra es ahora una opción muy viable. Recomiendo encarecidamente probar varios modelos con sus casos de uso específicos antes de tomar una decisión, ya que los rendimientos pueden variar considerablemente según el tipo de tarea.
Lo que me preocupa un poco es que la mayoría de los mejores modelos para los agentes IA son propietarios y controlados por grandes empresas. Esto significa que los desarrolladores y las empresas dependen en gran medida de estos proveedores para sus soluciones críticas. Creo que hay una oportunidad para que los modelos de código abierto recuperen terreno en el ámbito de la agentica 💡. Proyectos como DeepSeek y Mistral muestran que es posible crear modelos de alto rendimiento fuera del ecosistema de los gigantes de la tecnología, pero claramente tienen un largo camino por recorrer para competir con Claude y GPT.
Para los equipos que buscan implementar una estrategia de automatización basada en agentes IA, este ranking es un recurso valioso para evaluar las herramientas y modelos a utilizar. Recomiendo consultar regularmente el ranking Arena para mantenerse actualizado sobre los últimos rendimientos, ya que el panorama cambia rápidamente. Para saber más sobre cómo crear un agente IA para automatizar su vigilancia de marketing, consulte nuestras guías detalladas que le ayudarán a implementar estas tecnologías de manera efectiva.
Conclusión
El ranking agentico de Arena en septiembre de 2026 nos ofrece una fotografía fascinante del estado actual de la competencia en el ámbito de los agentes IA. Claude Fable 5.1 de Anthropic sigue siendo el campeón indiscutido, pero GPT-6 Astra de OpenAI muestra que la batalla apenas comienza. Lo que realmente me impresiona es la sofisticación de la metodología de Arena, que mide los rendimientos reales en lugar de los resultados sintéticos. Esto nos da una comprensión mucho mejor de lo que realmente funciona cuando se trata de pilotar agentes autónomos. Estoy convencido de que este ranking se convertirá en una referencia imprescindible para cualquiera que busque entender el panorama de los modelos de IA para la agentica.
Mirando hacia el futuro, creo que veremos una intensificación de la competencia entre Anthropic y OpenAI, con otros actores que intentarán hacerse un lugar. Las empresas y los desarrolladores que adopten rápidamente los mejores modelos para los agentes IA tendrán una ventaja competitiva significativa. Si busca implementar una estrategia de automatización basada en agentes IA, le recomiendo consultar este ranking y probar los modelos más efectivos con sus casos de uso específicos para maximizar su retorno de inversión.
📝 En Resumen
- Claude Fable 5.1 de Anthropic ocupa la primera posición en el ranking agentico de Arena en septiembre de 2026 con la tasa más alta de tareas validadas por los usuarios
- GPT-6 Astra de OpenAI asciende espectacularmente al segundo lugar, mostrando que la competencia se intensifica en el ámbito de los agentes IA
- La metodología de causal tracing de Arena mide los rendimientos reales basados en 1,7 millones de sesiones de usuarios, ofreciendo una evaluación más fiable que los benchmarks sintéticos
- Anthropic domina el top 10 con seis modelos, mientras que Google y Mistral se mantienen a distancia, creando una oportunidad para los actores emergentes de recuperar terreno